Ücretsiz ve açık kaynak · MIT
Belgelerini bilgisayarında dönüştür, Claude’un context’inde değil.
PDFStruct; PDF, DOCX, metin ve görsel dosyalarını kendi bilgisayarında on yapılandırılmış formata dönüştürür. Claude dosyanın tamamı yerine kısa sonuçlar alır. Bu, özellikle büyük belgelerde context ve token kullanımını azaltabilir.
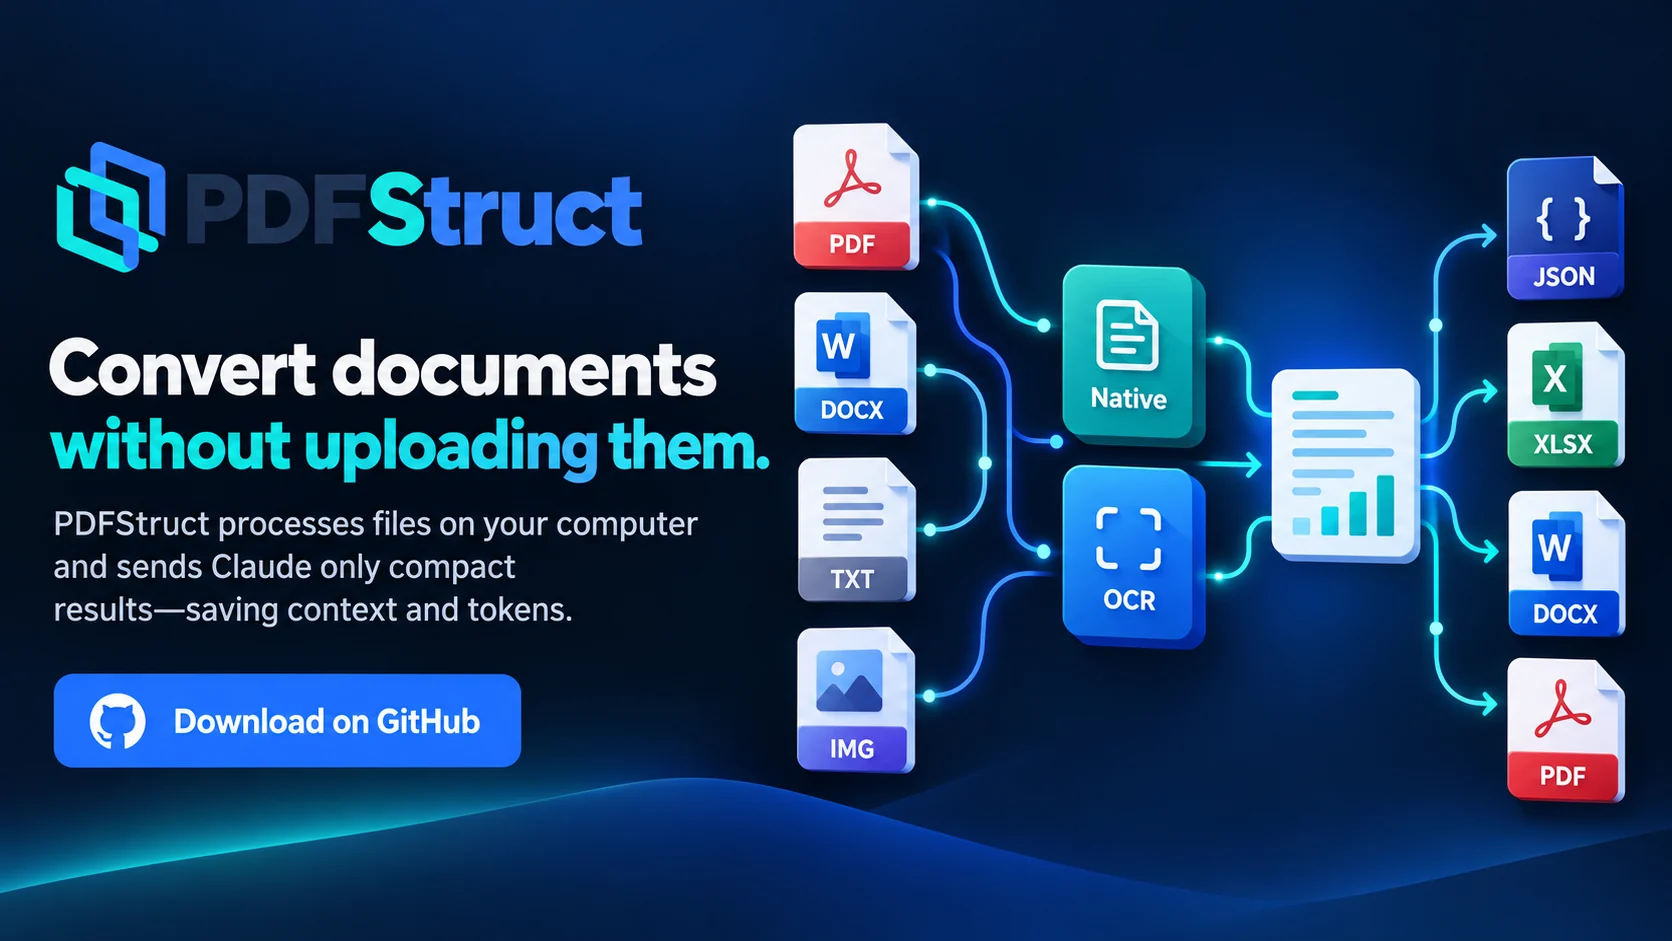
- 10 çıktı formatı
- Sayfa gerektirdiğinde OCR
- Claude’da daha az context ve token
- Ücretsiz ve açık kaynak
Neden PDFStruct?
-
Belgelerin bilgisayarında işlenir
Dosyalar kendi bilgisayarında okunur ve dönüştürülür. PDFStruct sunucusuna hiçbir şey yüklenmez ve kaynak dosyanın üzerine asla yazılmaz.
-
Büyük belgeler Claude’un context’ine taşınmaz
Claude dönüştürmeyi başlatır ve yalnızca kısa bir durum bilgisi ile çıktı yollarını alır. İçeriği ancak sen istediğinde ve küçük parçalar hâlinde okur.
-
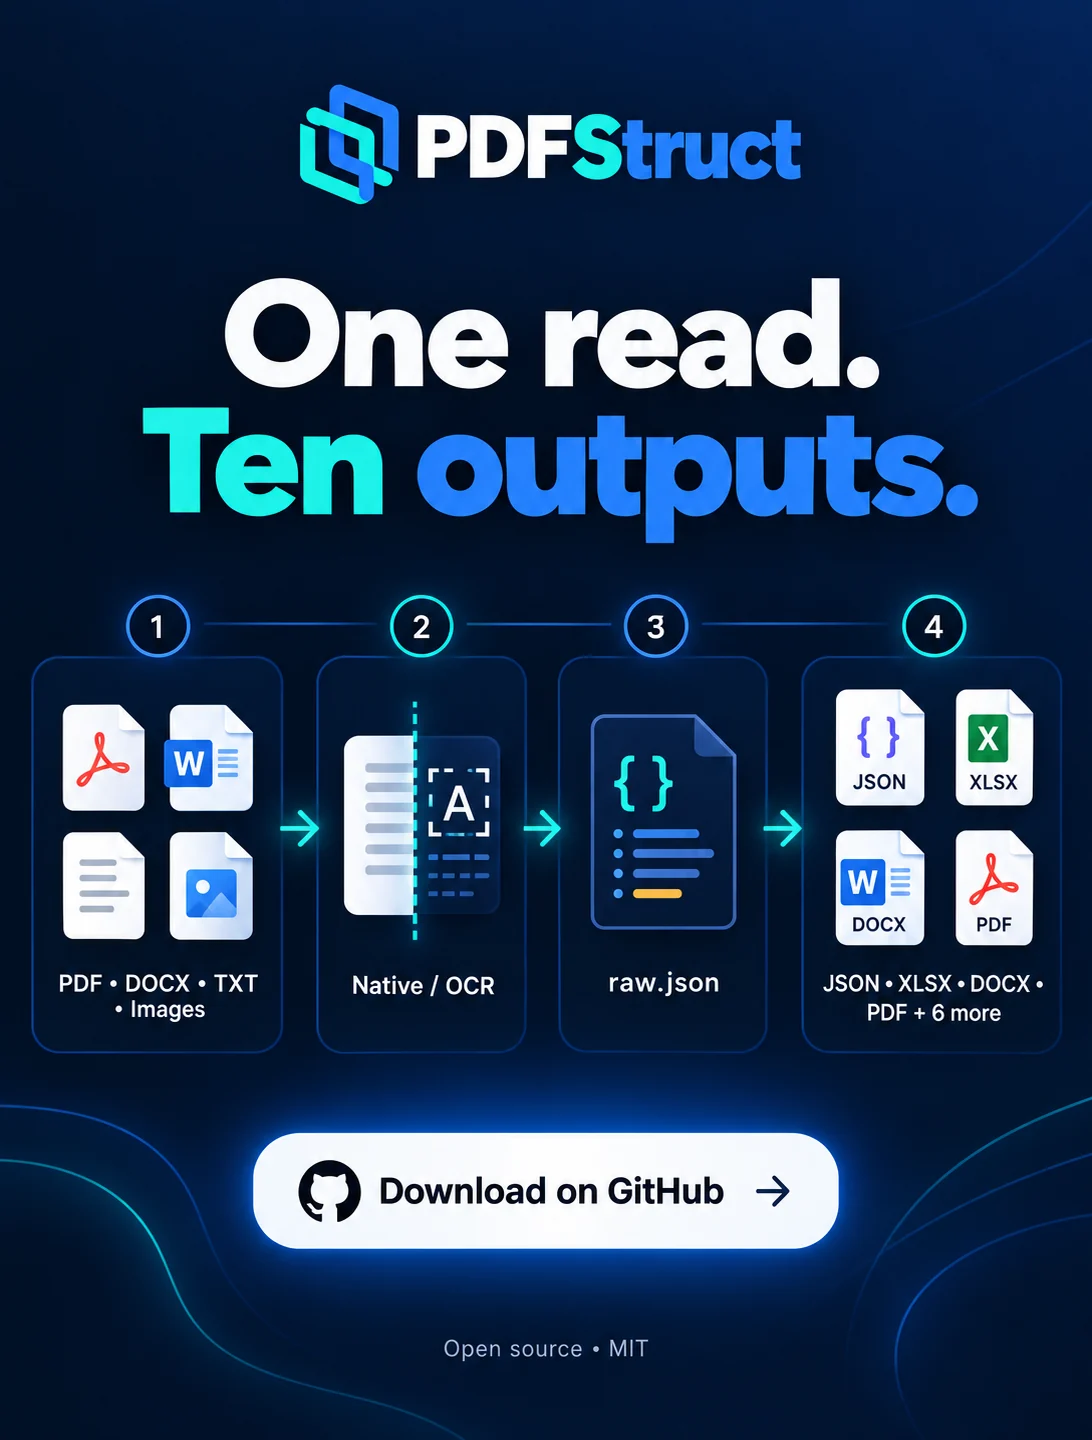
Tek okuma, on çıktı formatı
Her girdi bir kez okunur. İstediğin bütün formatlar aynı yapılandırılmış sonuçtan üretilir ve değişmemiş işler güvenle yeniden çalıştırılabilir.
Nasıl çalışır?
Dört adım; hangi yolla kullanırsan kullan aynı.
-
PDF, DOCX, metin veya görsel
Tek dosya, birkaç dosya ya da bir klasör ver.
-
Yerel metin çıkarımı veya OCR
Sayfanın metin katmanı yeterliyse doğrudan okunur. Zayıf veya taranmış sayfalar OCR’dan geçer.
-
raw.json
Her belge için tek bir yapılandırılmış sonuç. Güveni düşük sayfalar review_pages içinde işaretlenir.
-
10 çıktı formatı
İstenen bütün formatlar bu tek sonuçtan yazılır.
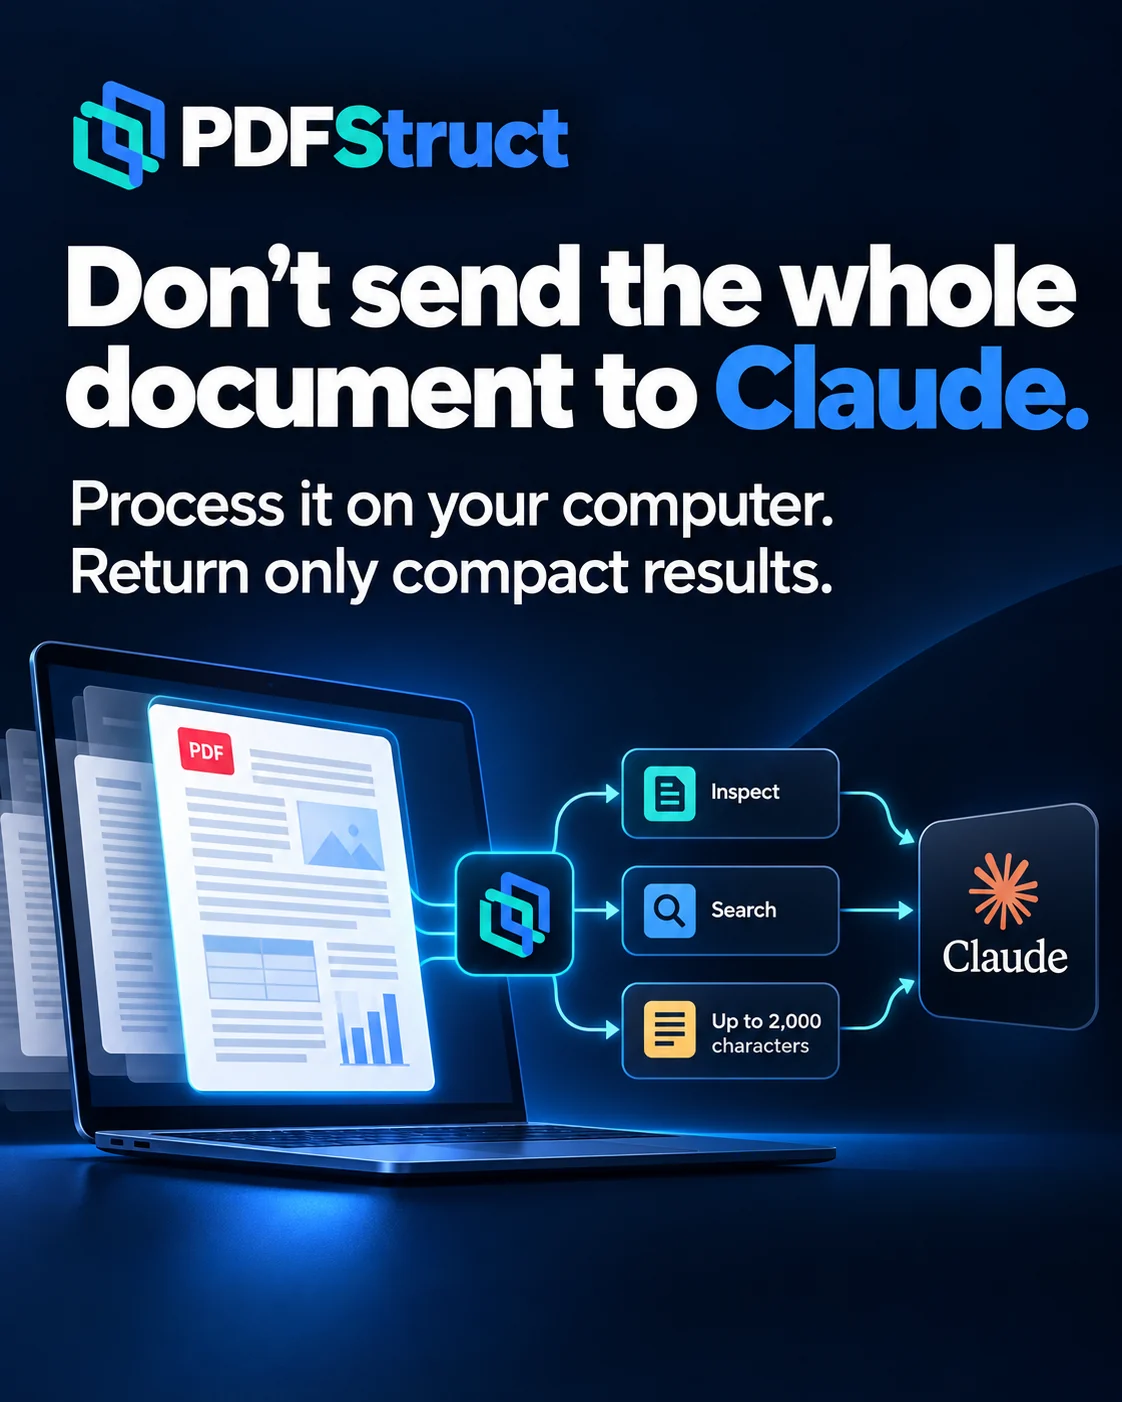
Claude ile
Daha az context, daha az token
Yerel MCP sunucusu sayesinde Claude, belgelerinin tamamını almadan onlarla çalışır. Her araç yalnızca gerekeni döndürür:
inspectdosyanın içeriğini değil, kısa metadata bilgisini döndürür.searchbir sorgu için hedefli sonuçlar getirir.read_excerptçağrı başına en fazla 2.000 karakter okur.convertbelge metni yerine kısa bir durum bilgisi ve çıktı yollarını döndürür.
Ne kadar context ve token tasarrufu sağlandığı belgeye göre değişir. Ölçülmüş ya da garanti edilen bir oran yoktur.
Desteklenen formatlar
On girdi türü ve on çıktı formatı. Bunların dışındakiler desteklenmez.
Girdi
- DOCX
- TXT
- Markdown
- HTML
- JPG
- PNG
- TIFF
- BMP
- WebP
Çıktı
- JSON
- HTML
- TXT
- Markdown
- CSV
- XLSX
- DOCX
- JSONL
- SQLite
İstediğin şekilde kullan
Her seçeneğin arkasında aynı motor var. Claude isteğe bağlı: PDFStruct onsuz da çalışır.
-
Masaüstü penceresi
Dosyaları sürükle, formatları işaretle, Convert’e bas. Windows’ta kurulum ZIP’i PDFStruct’ı kendi klasörüne kurar; Python 3.10–3.13 gerekir.
Güncellemeler ancak sen onayladıktan sonra kurulur; arka planda hiçbir şey çalışmaz. Bu sürümde taşınabilir paket yok.
-
Komut satırı ve betikler
Terminalde klavyeyle kullanılan bir menü ya da betikler ve otomasyon için soru sormayan tek komut. Wheel dosyasından pip ile kurulur; Python 3.10 veya üstü gerekir.
Henüz PyPI’da değil.
-
Claude Code ve Windows için Claude
Claude Code için plugin (skill ve MCP sunucusu kaydı) ve Claude masaüstü uygulaması için .mcpb eklentisi, Claude’un dönüştürmeleri senin bilgisayarında çalıştırmasını sağlar.
İkisi de yalnızca başlatıcıdır, içlerinde PDFStruct yoktur: önce PDFStruct’ı Windows kurulumuyla kur. Plugin kullanıyorsan ayrı skill ZIP’ini ayrıca ekleme.
Gizlilik
Belgelerin kendi bilgisayarında işlenir.
- Belgeler PDFStruct sunucusuna yüklenmez.
- Hesap gerekmez.
- Varsayılan olarak telemetri yoktur.
- Yapay kullanım limiti ve zorunlu ödeme yoktur.
Bilmen gereken tek istisna: OCR ilk kez gerektiğinde PDFStruct, OCR modellerini bir kez indirir (yaklaşık 70 MB). Bu adım için internet bağlantısı gerekir.
Yapmadıkları
PDFStruct metni ve yapıyı çıkarır. Bir tablo çıkarma aracı ya da sayfa düzenini koruyan bir dönüştürücü değildir.
- Tablo yapısını yeniden kurmaz. CSV ve XLSX çıktıları gerçek tablo değil, metin bloklarının listesidir.
- DOCX’ten PDF’e dönüştürme özgün düzeni birebir korumaz. Üretilen PDF, okunabilir bir yeniden akıştır.
- Yapay zekâyla özetleme veya alan çıkarımı yapmaz.
- Ölçülmüş bir hız ya da doğruluk oranı yoktur.
- İlk OCR kullanımında modeller indirilir (yaklaşık 70 MB).
Ücretsiz ve açık kaynak
- MIT lisanslı.
- Kullanımı ücretsiz.
- Premium ya da Pro katmanı yok.
- Hiçbir temel özellik bağışa bağlı değil.
- Kaynak kod GitHub’da.
Projeyi destekle
PDFStruct ücretsiz ve açık kaynak. İşine yaradıysa bana bir çay veya kahve ısmarlayarak geliştirmeyi destekleyebilirsin.
Bağış tamamen gönüllüdür ve hiçbir özelliği açmaz: bütün özellikler zaten ücretsiz.
Sorular
PDFStruct ücretsiz mi?
Evet. MIT lisanslıdır, Premium ya da Pro katmanı ve kullanım limiti yoktur. Bağışlar gönüllüdür ve hiçbir özelliği açmaz.
Belgelerim bir yere yükleniyor mu?
Hayır. Belgeler bilgisayarında işlenir ve PDFStruct sunucusuna gönderilmez. İndirilen tek şey, OCR ilk kez gerektiğinde bir defaya mahsus inen OCR modelleridir (yaklaşık 70 MB).
OCR ne zaman kullanılıyor?
Yalnızca sayfa gerektirdiğinde. Sayfanın metin katmanı yeterliyse metin doğrudan okunur. Zayıf veya taranmış sayfalar ile görseller OCR’dan geçer.
Claude’un token ve context tüketimini nasıl azaltıyor?
Belgenin tamamı Claude’a hiç gönderilmez. inspect kısa metadata döndürür, search hedefli sonuçlar getirir, read_excerpt çağrı başına en fazla 2.000 karakter okur, convert ise durum bilgisi ve çıktı yollarını döndürür. Tasarruf belgeye göre değişir; garanti edilen bir oran yoktur.
Hangi formatları destekliyor?
Girdi: PDF, DOCX, TXT, Markdown, HTML, JPG, PNG, TIFF, BMP ve WebP. Çıktı: JSON, HTML, TXT, Markdown, CSV, XLSX, DOCX, JSONL, SQLite ve PDF.
Tabloları ve sayfa düzenini koruyor mu?
Hayır. Tabloları yeniden kurmaz: CSV ve XLSX metin blokları içerir. DOCX’ten üretilen PDF, özgün düzenin kopyası değil, okunabilir bir yeniden akıştır.
PDFStruct’ı edin
Son kararlı sürümü indir ya da kaynak kodu incele.