Kostenlos & Open Source · MIT
Dokumente auf deinem Rechner umwandeln, nicht in Claudes Kontext.
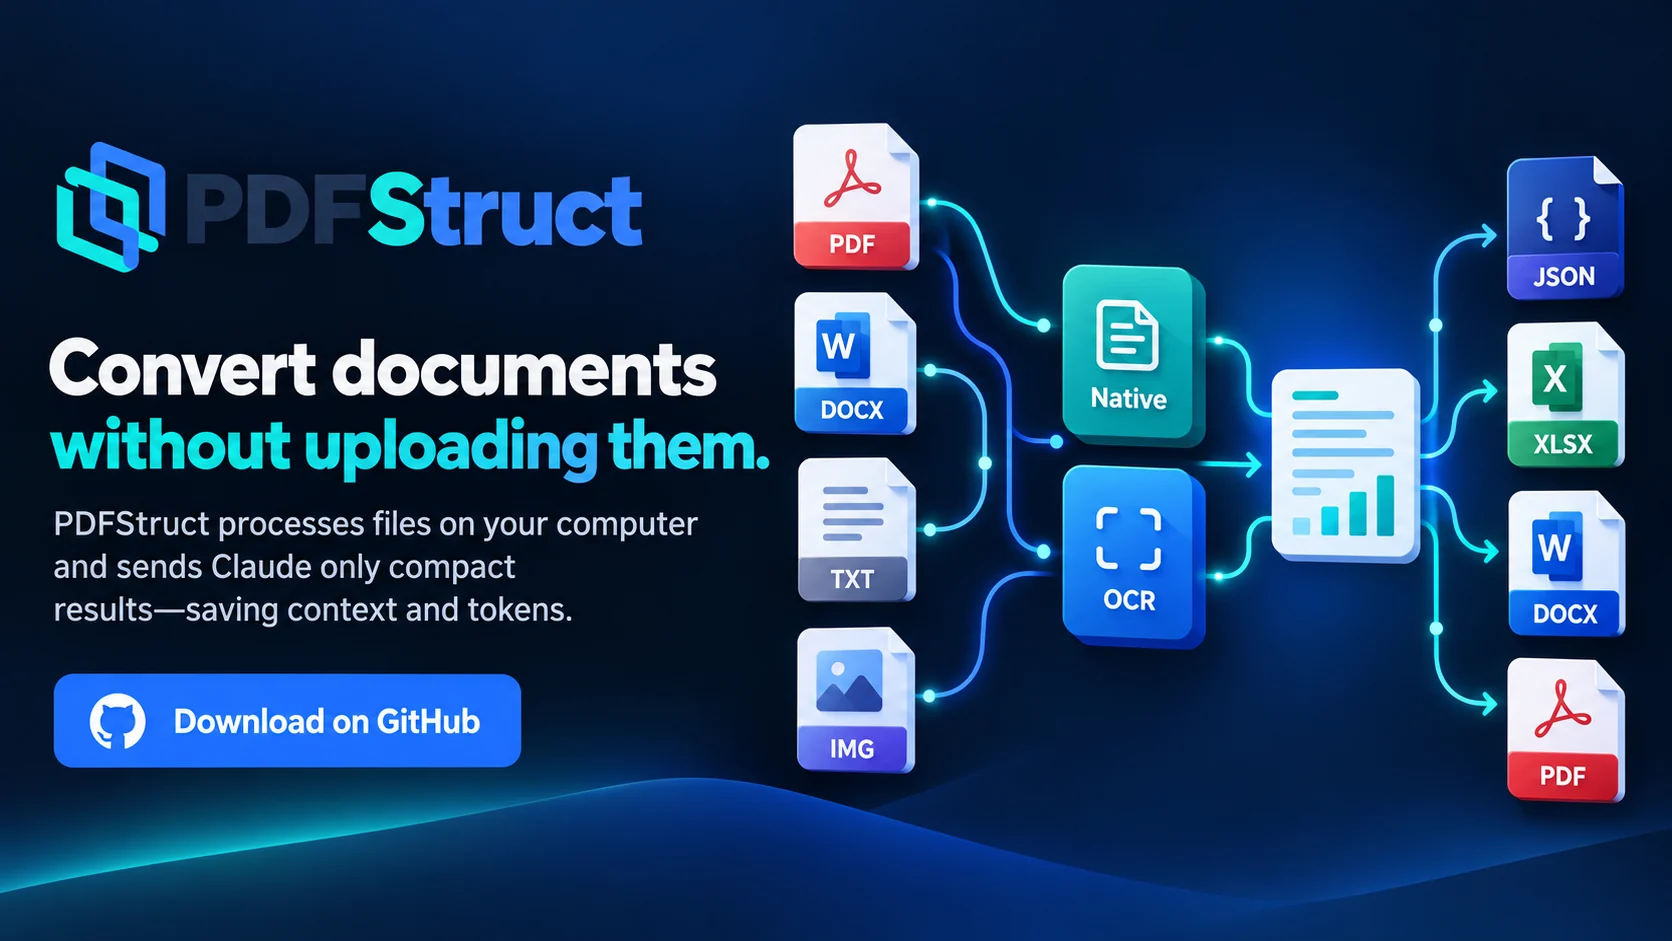
PDFStruct wandelt PDF-, DOCX-, Text- und Bilddateien auf deinem eigenen Rechner in zehn strukturierte Formate um. Claude erhält kurze Ergebnisse statt der ganzen Datei. Das kann Kontext und Tokens sparen, besonders bei großen Dokumenten.
- 10 Ausgabeformate
- OCR, wenn eine Seite es braucht
- Weniger Kontext und Tokens in Claude
- Kostenlos und Open Source
Warum PDFStruct?
-
Deine Dokumente werden auf deinem Rechner verarbeitet
Dateien werden auf deinem eigenen Rechner gelesen und umgewandelt. Nichts wird auf einen PDFStruct-Server hochgeladen, und die Quelldatei wird nie überschrieben.
-
Große Dokumente bleiben außerhalb von Claudes Kontext
Claude startet die Umwandlung und bekommt einen kurzen Status und die Ausgabepfade zurück. Den Inhalt liest Claude nur, wenn du es verlangst, und dann nur in kleinen Stücken.
-
Einmal lesen, zehn Ausgabeformate
Jede Eingabe wird einmal gelesen. Alle gewünschten Formate entstehen aus demselben strukturierten Ergebnis, und unveränderte Aufträge lassen sich gefahrlos erneut ausführen.
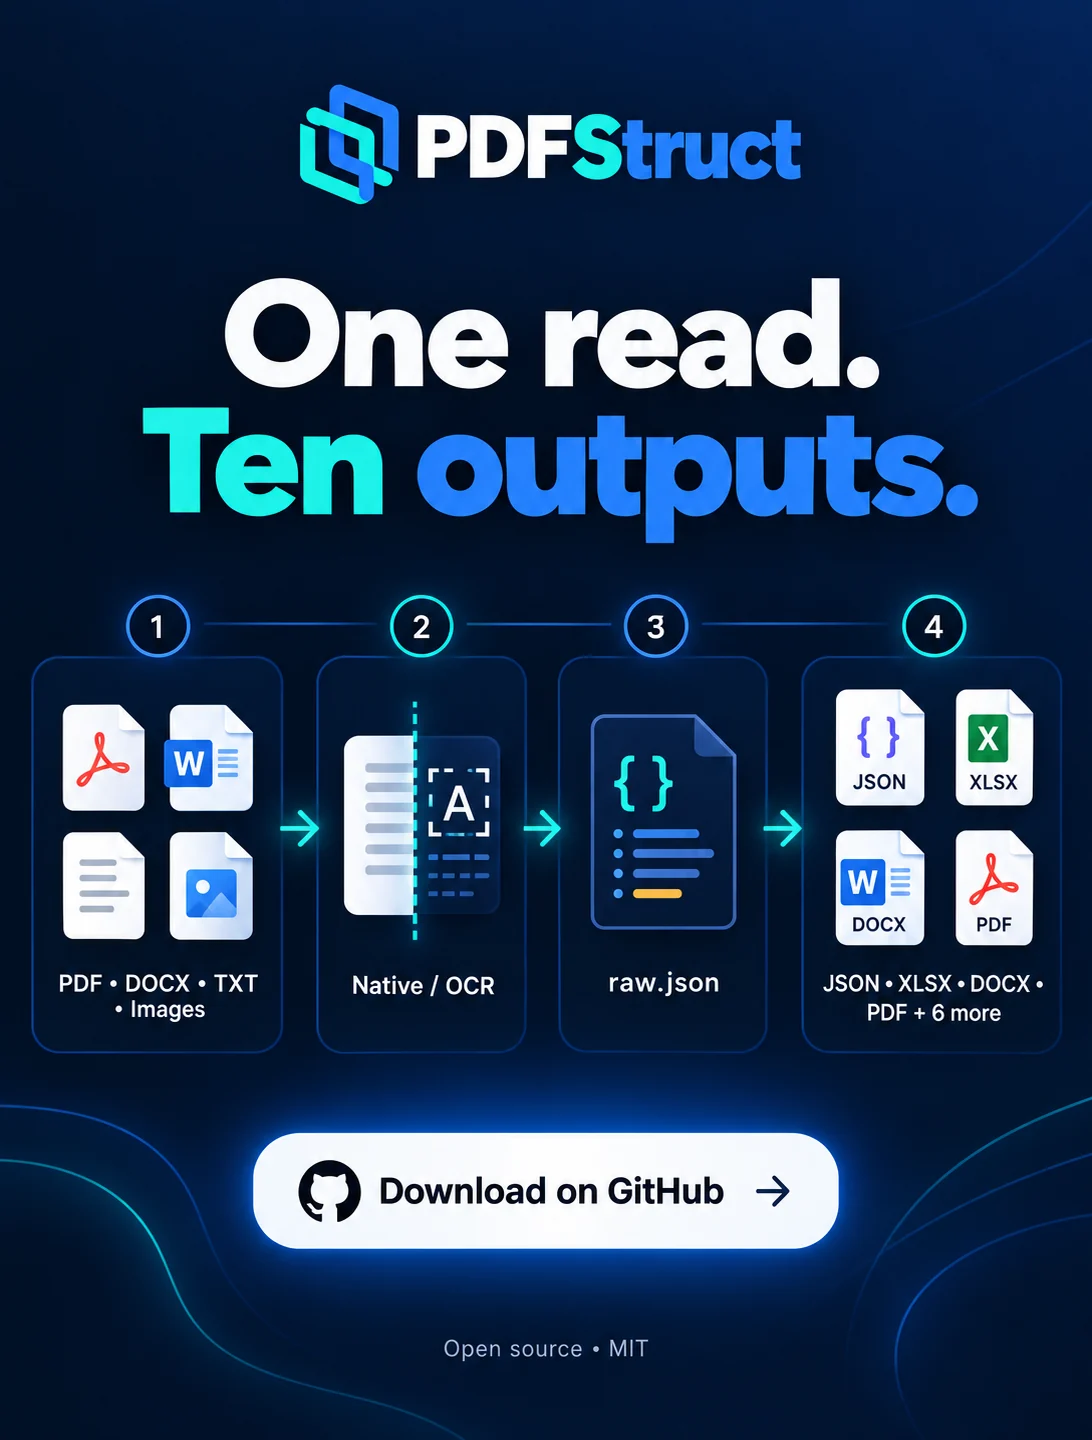
So funktioniert es
Vier Schritte, bei jeder Art der Nutzung gleich.
-
PDF, DOCX, Text oder Bild
Eine Datei, mehrere Dateien oder ein Ordner.
-
Native Extraktion oder OCR
Hat eine Seite eine brauchbare Textebene, wird sie direkt gelesen. Schwache oder gescannte Seiten laufen über OCR.
-
raw.json
Ein strukturiertes Ergebnis pro Dokument. Seiten mit geringer Sicherheit stehen in review_pages.
-
10 Ausgabeformate
Alle gewünschten Formate werden aus diesem einen Ergebnis geschrieben.
Mit Claude
Weniger Kontext, weniger Tokens
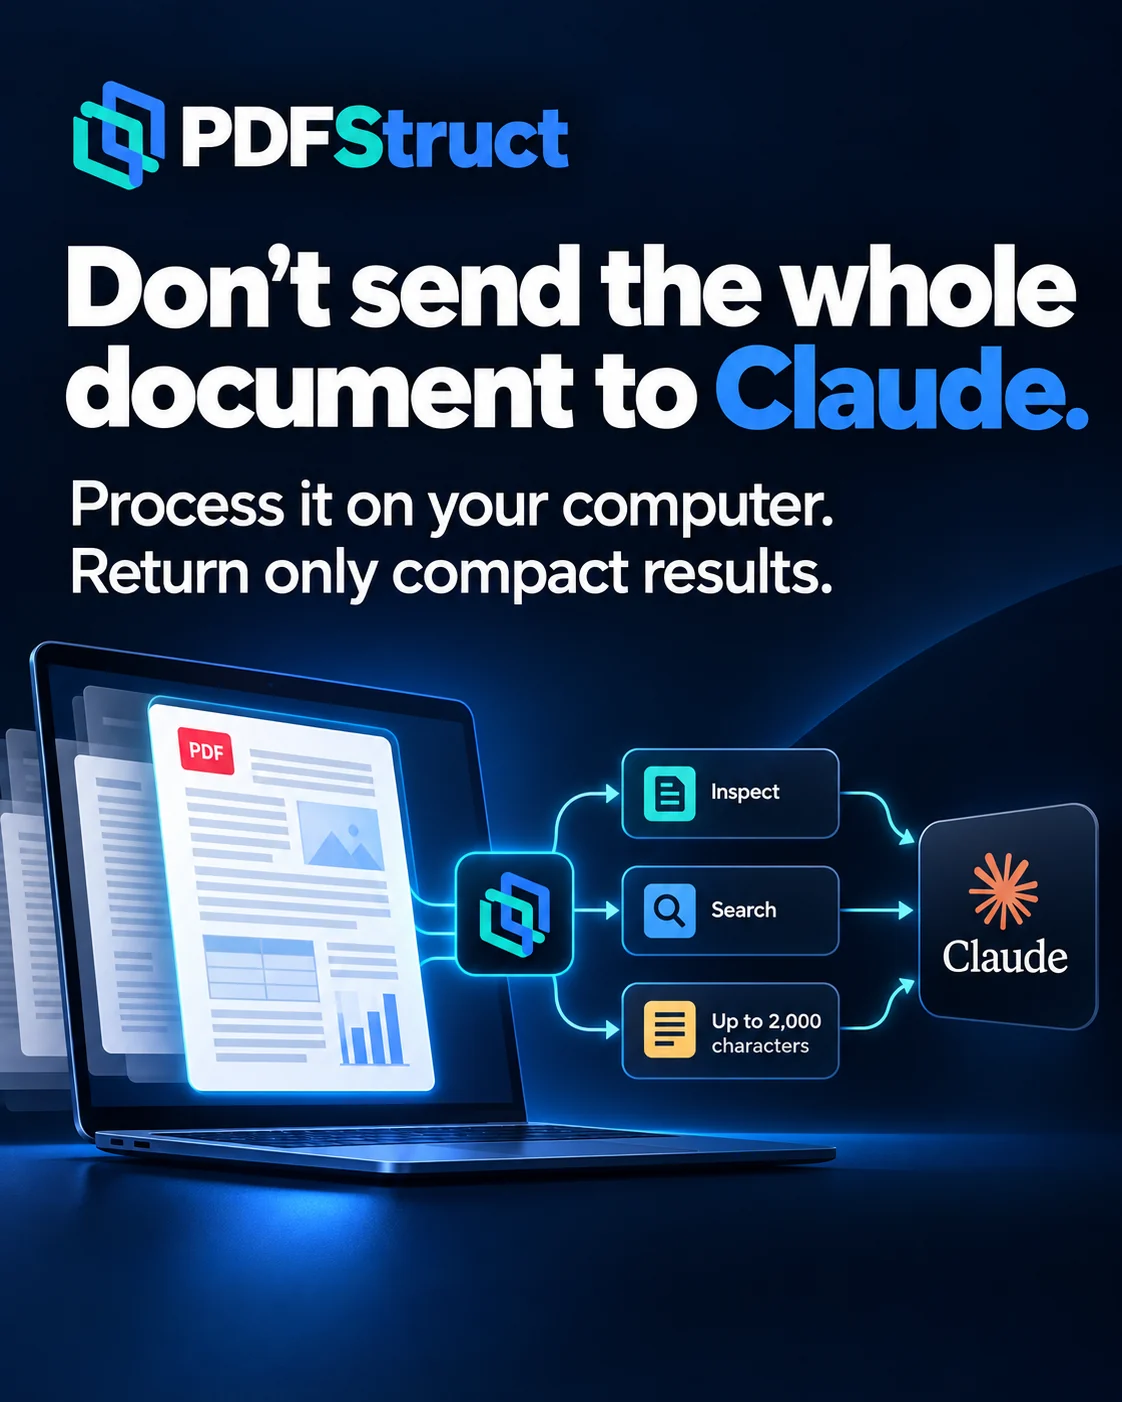
Über den lokalen MCP-Server arbeitet Claude mit deinen Dokumenten, ohne sie vollständig zu erhalten. Jedes Werkzeug liefert nur, was gebraucht wird:
inspectliefert kurze Metadaten zur Datei, nicht ihren Inhalt.searchbringt gezielte Treffer zu einer Suchanfrage.read_excerptliest höchstens 2.000 Zeichen pro Aufruf.convertgibt einen kurzen Status und die Ausgabepfade zurück statt des Dokumenttexts.
Wie viel Kontext und wie viele Tokens das spart, hängt vom Dokument ab. Es gibt keinen gemessenen oder garantierten Wert.
Unterstützte Formate
Zehn Eingabetypen und zehn Ausgabeformate. Mehr wird nicht unterstützt.
Eingabe
- DOCX
- TXT
- Markdown
- HTML
- JPG
- PNG
- TIFF
- BMP
- WebP
Ausgabe
- JSON
- HTML
- TXT
- Markdown
- CSV
- XLSX
- DOCX
- JSONL
- SQLite
So nutzt du es
Hinter jeder Variante steckt dieselbe Engine. Claude ist optional: PDFStruct funktioniert auch ohne.
-
Desktop-Fenster
Dateien hineinziehen, Formate ankreuzen, auf Convert klicken. Unter Windows installiert das Setup-ZIP PDFStruct in einen eigenen Ordner; es benötigt Python 3.10 bis 3.13.
Updates werden erst installiert, nachdem du sie bestätigt hast; im Hintergrund läuft nichts. Dieses Release enthält keine portable Version.
-
Kommandozeile und Skripte
Ein Tastaturmenü im Terminal oder ein einzelner Befehl ohne Rückfragen für Skripte und Automatisierung. Installation per pip aus dem Wheel; benötigt Python 3.10 oder neuer.
Noch nicht auf PyPI.
-
Claude Code und Claude für Windows
Ein Plugin für Claude Code (der Skill plus die Registrierung des MCP-Servers) und eine .mcpb-Erweiterung für die Claude-Desktop-App lassen Claude Umwandlungen auf deinem Rechner starten.
Beide sind nur Starter ohne eigene PDFStruct-Kopie: Installiere PDFStruct zuerst mit dem Windows-Setup. Wenn du das Plugin nutzt, füge das separate Skill-ZIP nicht zusätzlich hinzu.
Installationsreihenfolge in den Release Notes (öffnet in neuem Tab)
Datenschutz
Deine Dokumente werden auf deinem Rechner verarbeitet.
- Dokumente werden nicht auf einen PDFStruct-Server hochgeladen.
- Es ist kein Konto nötig.
- Standardmäßig keine Telemetrie.
- Keine künstlichen Nutzungsgrenzen und keine Pflichtzahlung.
Eine Ausnahme solltest du kennen: Wenn OCR zum ersten Mal gebraucht wird, lädt PDFStruct die OCR-Modelle einmal herunter (etwa 70 MB). Dafür ist eine Internetverbindung nötig.
Was es nicht kann
PDFStruct extrahiert Text und Struktur. Es ist kein Tabellen-Extraktor und kein layoutgetreuer Konverter.
- Es baut keine Tabellen nach. CSV- und XLSX-Ausgaben sind Listen von Textblöcken, keine echten Tabellen.
- DOCX zu PDF behält das ursprüngliche Layout nicht bei. Das erzeugte PDF ist ein lesbarer Neuumbruch.
- Es fasst Dokumente nicht mit KI zusammen und extrahiert keine Felder.
- Es gibt keine gemessenen Werte zu Geschwindigkeit oder Genauigkeit.
- Beim ersten OCR-Lauf werden die Modelle heruntergeladen (etwa 70 MB).
Kostenlos und Open Source
- MIT-Lizenz.
- Kostenlos nutzbar.
- Keine Premium- oder Pro-Stufe.
- Keine Kernfunktion hängt von einer Spende ab.
- Der Quellcode liegt auf GitHub.
Das Projekt unterstützen
PDFStruct ist kostenlos und Open Source. Wenn es dir Zeit spart, kannst du die Entwicklung mit einem Tee oder Kaffee unterstützen.
Eine Spende ist freiwillig und schaltet nichts frei: Alle Funktionen sind bereits kostenlos.
Fragen
Ist PDFStruct kostenlos?
Ja. Es steht unter der MIT-Lizenz, hat keine Premium- oder Pro-Stufe und keine Nutzungsgrenzen. Spenden sind freiwillig und schalten nichts frei.
Werden meine Dokumente hochgeladen?
Nein. Dokumente werden auf deinem Rechner verarbeitet und nicht an einen PDFStruct-Server gesendet. Heruntergeladen werden nur die OCR-Modelle (etwa 70 MB), einmalig, wenn OCR zum ersten Mal gebraucht wird.
Wann wird OCR verwendet?
Nur, wenn eine Seite es braucht. Ist die Textebene der Seite gut genug, wird der Text direkt gelesen. Schwache oder gescannte Seiten und Bilder laufen über OCR.
Wie senkt es den Token- und Kontextverbrauch in Claude?
Das ganze Dokument wird nie an Claude geschickt. inspect liefert kurze Metadaten, search gezielte Treffer, read_excerpt liest höchstens 2.000 Zeichen pro Aufruf, und convert gibt einen Status und Ausgabepfade zurück. Die Ersparnis hängt vom Dokument ab; einen garantierten Wert gibt es nicht.
Welche Formate werden unterstützt?
Eingabe: PDF, DOCX, TXT, Markdown, HTML, JPG, PNG, TIFF, BMP und WebP. Ausgabe: JSON, HTML, TXT, Markdown, CSV, XLSX, DOCX, JSONL, SQLite und PDF.
Bleiben Tabellen und Seitenlayout erhalten?
Nein. Tabellen werden nicht nachgebaut: CSV und XLSX enthalten Textblöcke. Ein aus einem DOCX erzeugtes PDF ist ein lesbarer Neuumbruch, keine Kopie des ursprünglichen Layouts.
PDFStruct holen
Lade die aktuelle stabile Version herunter oder lies den Quellcode.