Yerel web araştırması · CLI ve MCP
Web araştırması kendi bilgisayarında. Ham sayfa yerine kanıt.
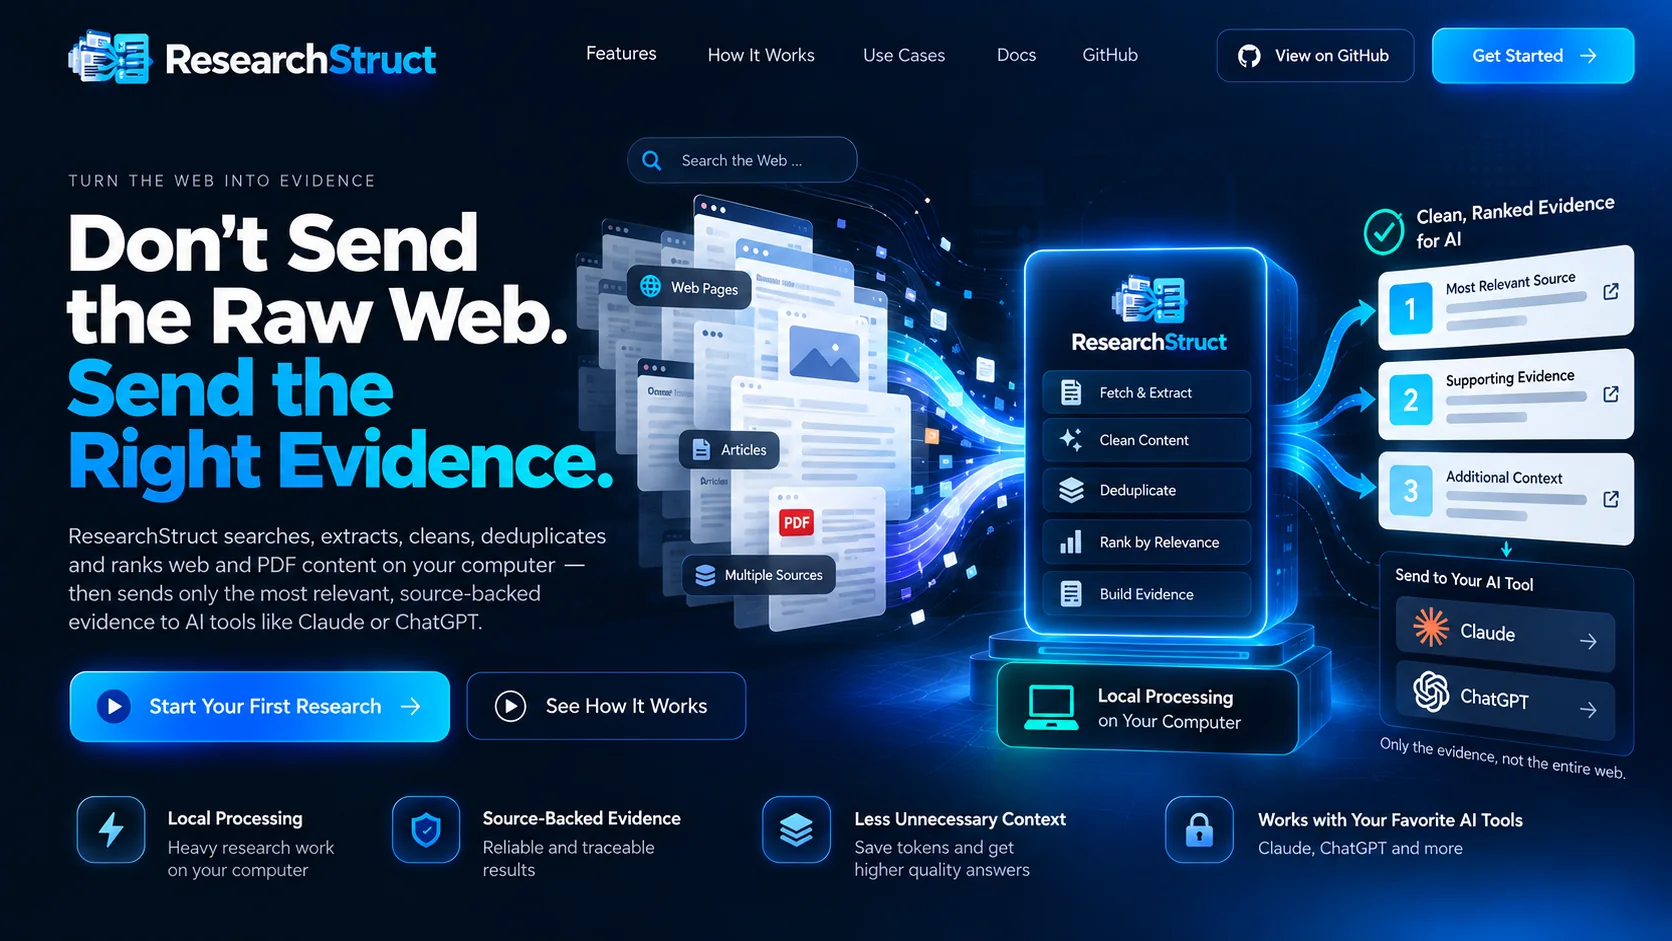
ResearchStruct web’de arar, sayfaları ve metin PDF’lerini indirir, tekrarları ayıklar ve pasajları yerelde sıralar. Sen ya da Claude, kaynaklı küçük bir kanıt paketi alırsınız. Bu adımların hiçbirinde dil modeli kullanılmaz.
Sürüm 0.4.2 · MIT lisansı · Python 3.10+ · depo şu an özel.
- Python CLI
- Yerel MCP sunucusu
- API anahtarı yok
- Her pasaj için kaynak
Geriye ne döner?
-
Küçük, alıntılanabilir girdi
Bir çalıştırma 8 ile 25 arasında sıralı pasaj döndürür; her birinin kaynak adresi, PDF’lerde sayfa numarası vardır.
-
Deterministik sıralama
BM25, TF-IDF, tam terimler, başlıklar, kaynak kalitesi ve güncellik; sabit ağırlıklarla birleştirilir.
-
Zayıf kanıtı gizlemez
Eksik anahtar terimler veya eksik resmi kaynak gibi uyarılar her sonucun parçasıdır.
Sorudan kanıt paketine.
-
Sor
Komut satırından ya da Claude üzerinden bir soru veya adres ver.
-
Ara ve indir
Web araması yapılır, bulunan sayfalar ve metin PDF’leri indirilir.
-
Temizle ve sırala
Ana içerik çıkarılır, tekrarlar ayıklanır, pasajlar sıralanır.
-
Kanıt paketi
En iyi pasajlar JSON ve Markdown olarak bir klasöre yazılır.
Neden ResearchStruct?
Bütün web sayfalarını sohbete yüklemek bağlamı tüketir ve önemli satırları gömer. ResearchStruct toplama ve sıralamayı kendi bilgisayarında yapar; asistan yalnızca seçilenleri görür.
- Yerelde çalışır: ağ trafiği yalnızca arama ve indirilen sayfalardır
- Tek çekirdek, iki arayüz: CLI ve MCP sunucusu aynı işlem hattını kullanır
- Claude Code ve Claude masaüstü için dört MCP aracı
- İkinci bir komut, bütün bir belgeyi yapılandırılmış kayıtlara çevirir
Kapsam ve sınırlar.
ResearchStruct 1.0 öncesi bir sürümdür ve tek kişi tarafından geliştirilir. Kapsamı bilinçli olarak dardır.
- OCR yok: taranmış PDF’ler bildirilir ve atlanır
- Embedding yok, dil modeli yok
- Tek arama altyapısı
- PyPI’da yayımlanmadı
Web’den gelen metin güvenilmeyen veri sayılır, asla talimat olarak işlenmez.
ResearchStruct ilgini çekti mi?
Depo şimdilik özel. Denemek ya da aynı yaklaşımı kendi projende kullanmak istersen bana yaz.