Lokale Web-Recherche · CLI & MCP
Web-Recherche auf dem eigenen Rechner. Belege statt roher Webseiten.
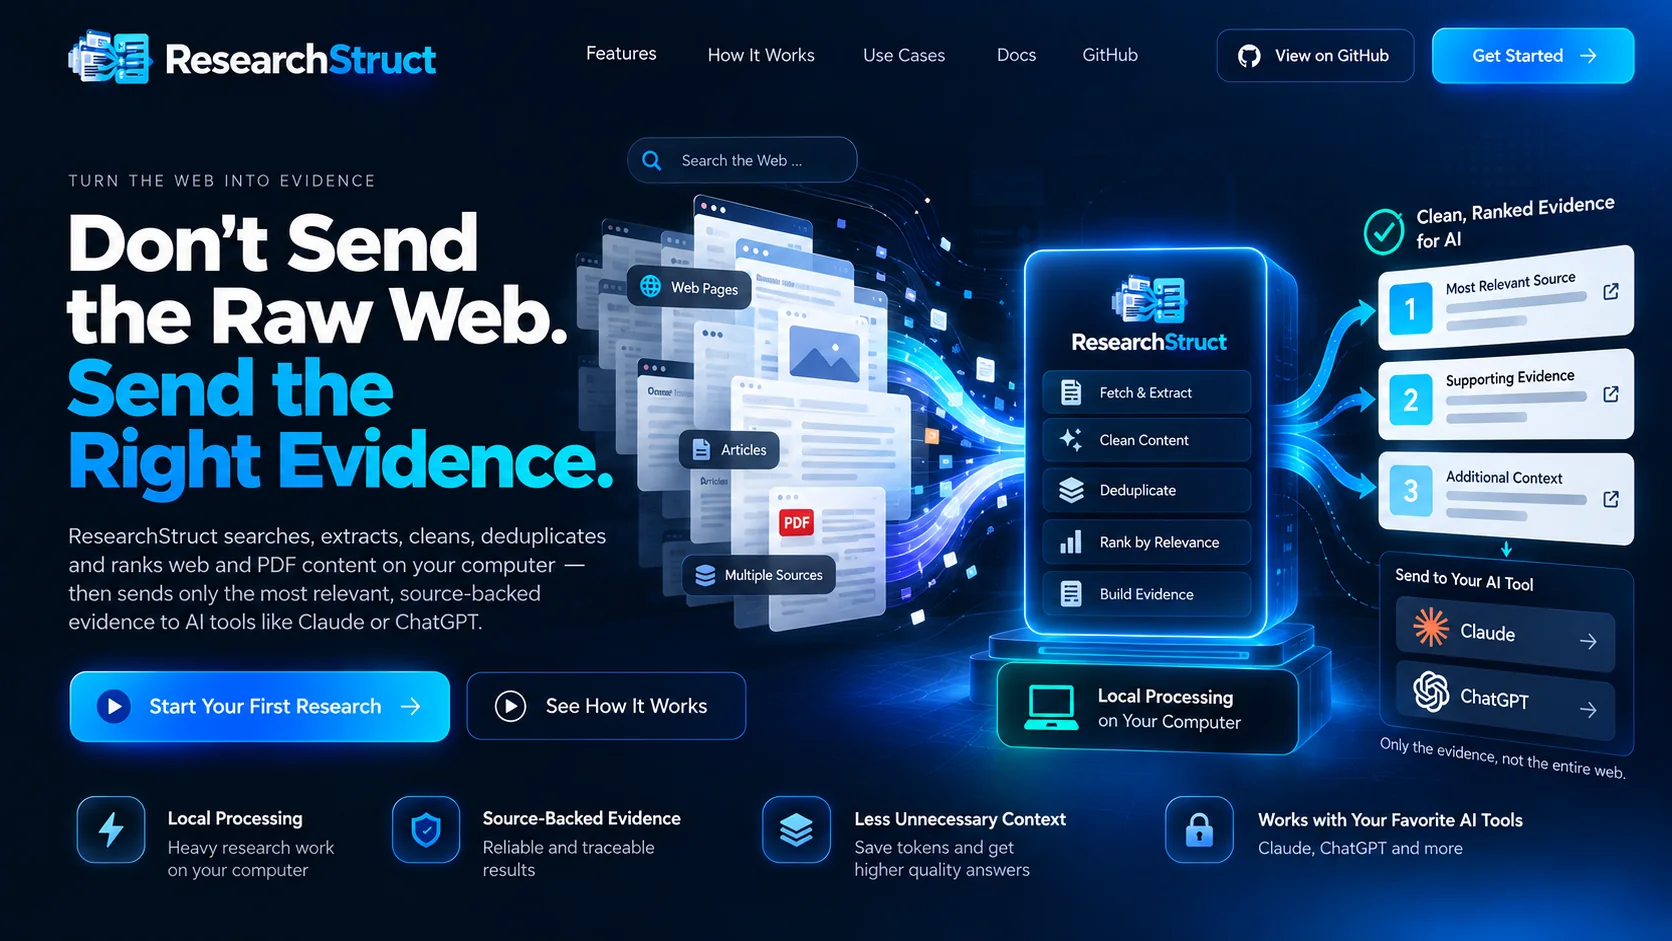
ResearchStruct durchsucht das Web, lädt Seiten und Text-PDFs, entfernt Dubletten und bewertet die Textstellen lokal. Sie oder Claude erhalten ein kleines Belegpaket mit Quellen. An keinem dieser Schritte ist ein Sprachmodell beteiligt.
Version 0.4.2 · MIT-Lizenz · Python 3.10+ · das Repository ist derzeit privat.
- Python-CLI
- Lokaler MCP-Server
- Kein API-Schlüssel
- Quelle zu jeder Textstelle
Was zurückkommt.
-
Kleine, zitierbare Eingabe
Ein Lauf liefert 8 bis 25 bewertete Textstellen, jede mit Quell-URL und bei PDFs mit Seitenzahl.
-
Deterministisches Ranking
BM25, TF-IDF, exakte Begriffe, Überschriften, Quellenqualität und Aktualität, mit festen Gewichten kombiniert.
-
Ehrlich bei dünner Beleglage
Warnungen wie fehlende Schlüsselbegriffe oder eine fehlende offizielle Quelle gehören zu jedem Ergebnis.
Von der Frage zum Belegpaket.
-
Fragen
Eine Frage oder eine URL übergeben, in der Kommandozeile oder über Claude.
-
Suchen & abrufen
Eine Websuche läuft, gefundene Seiten und Text-PDFs werden geladen.
-
Bereinigen & bewerten
Der Hauptinhalt wird extrahiert, Dubletten entfallen, Textstellen werden bewertet.
-
Belegpaket
Die besten Textstellen landen als JSON und Markdown in einem Ordner.
Warum ResearchStruct?
Ganze Webseiten in eine Unterhaltung zu laden kostet Kontext und verdeckt die relevanten Zeilen. ResearchStruct sammelt und bewertet auf dem eigenen Rechner, sodass der Assistent nur die Auswahl sieht.
- Läuft lokal: Netzwerkverkehr entsteht nur durch die Suche und die abgerufenen Seiten
- Ein Kern, zwei Zugänge: CLI und MCP-Server nutzen dieselbe Pipeline
- Vier MCP-Werkzeuge für Claude Code und Claude Desktop
- Ein zweiter Befehl macht aus einem ganzen Dokument strukturierte Datensätze
Umfang und Grenzen.
ResearchStruct ist vor Version 1.0 und wird von einer Person gepflegt. Der Umfang ist bewusst schmal.
- Kein OCR: gescannte PDFs werden gemeldet und übersprungen
- Keine Embeddings und kein Sprachmodell
- Ein Such-Backend
- Nicht auf PyPI veröffentlicht
Text aus dem Web gilt als nicht vertrauenswürdige Daten, nie als Anweisung.
Interesse an ResearchStruct?
Das Repository ist vorerst privat. Schreiben Sie mir, wenn Sie es ausprobieren oder denselben Ansatz im eigenen Projekt nutzen möchten.